Lance Table Format
一张"表"需要回答四个问题:这张表的 schema 是什么;在某一时刻,哪些文件里的哪些字节属于这张表;怎么原子地从一个状态变到下一个状态(否则读的人会看到半成品);以及能不能回到过去(复现训练用的数据快照)。所有表格式(Iceberg、Delta、Hudi、Lance)都在回答同样的四个问题,差别在于它们各自假设的存储介质和访问模式不同。
考虑到存储介质(S3/OSS)的性质,数据文件永远不改,一切变更都变成"写新文件 + 写一份新的清单",也就是新增一份新的 manifest 文件。
1. Versions:弱化 Catalog
Iceberg 里 catalog 干两件事:一是"提交原子性 + 当前版本指针",二是"表的注册、发现、权限、跨表管理"。在 Lance 中,前一件事完全从 Catalog 中移除,由文件名 + 对象存储条件写来负责。其核心是"当前版本是谁"这个信息能从目录本身推出来。
-
倒序版本号
最朴素的想法:LIST 一下
_versions/,把所有 manifest 文件名里的版本号解析出来,取最大值。这在逻辑上是对的,但有个性能问题:一张表可能被更新过几万次(Lance 常用于向量场景,频繁 append/建索引),_versions/下就有几万个文件。Lance 采取的思路是“让最新版本排在 LIST 的第一条”。对象存储的 LIST 有一个可以利用的特性:返回结果是按 key 的字典序(字节序)升序排列的,并且你可以只要前 N 条(
max_keys=1)。因此只要把版本号翻转过来存,文件名不用version,而用u64::MAX - version:version 1 → 18446744073709551615 - 1 = 18446744073709551614.manifest version 2 → 18446744073709551615 - 2 = 18446744073709551613.manifest version 3 → 18446744073709551615 - 3 = 18446744073709551612.manifest ...版本越新,数字越小,字典序越靠前。LIST
_versions/O(1) 取第一条,就是最新版本。注意字典序和数值序不一样。字符串比较里 "10" < "9",所以文件名必须定长补零到 20 位。另外 Lance 早期版本就是
1.manifest、2.manifest这样命名的(Naming Scheme V1),后来才换成翻转补零的 V2 方案,老表还能读,新建表默认用 V2。 -
并发提交原子性
Lance 的并发原子性由对象存储的条件写(put-if-not-exists,S3 在 2024 年之后原生支持,GCS/Azure 早就支持)来保证。两个写者都想写 N+1 这个 key,只有一个 PUT 会成功,另一个收到冲突错误,重新 LIST 拿到 N+1,再试 N+2。所有原子性都由对象存储自己提供,不需要外部数据库。
对于不支持条件写的老存储,Lance 留了一个可插拔的 commit handler,可以接 DynamoDB 之类做锁兜底。
-
latest_version_hint.json加速LIST 已经是 O(1) 了,但在对象存储上 LIST 相比 GET/HEAD 还是很慢,所以 Lance 加了一条更快的路径:
- 先 GET 一个很小的
latest_version_hint.json,里面写着比如{"version": 42}。这代表"至少已经有 42 版了"——因为它可能过期(别人刚提交了 43,还没来得及更新 hint)。 - 于是从 42 开始 HEAD 探测:42 存在?43 存在?……直到某个版本 404,前一个就是最新。通常只需要一两次 HEAD。
- 如果 hint 文件不存在、损坏、或者明显不对,就退回去走 LIST 路径。
正确性由 LIST + 不可变的 manifest 文件保证,hint 只负责快。它是提交完成之后才顺手写的,写失败也无所谓,被删了也无所谓,落后了也无所谓——最坏情况就是多做几次 HEAD 或者退回 LIST。正因为它不承担正确性,它是整个目录里唯一一个原地覆盖写的文件(对象存储的 PUT 本身是原子的,不会写一半失败),而 json 记录的版本过新/过旧都有兜底手段(回退 LIST / 向上 HEAD 探测)。
- 先 GET 一个很小的
-
可扩展的 catalog 服务:跨表治理
当开始问"有哪些表"而不是"这张表最新版本是谁"的时候,仍需要一个 Catalog 来完成。Lance 为这一层提供了 Lance Namespace 规范,可以对接 Hive Metastore、Glue、Unity Catalog、REST 服务等,其本质就是一个"表名 → 目录路径"的映射加上治理功能。
- 表发现与命名:几百张表散在不同 bucket,需要按
db.schema.table找,而不是记路径。 - 权限:谁能读哪张表,不想靠对象存储的 IAM 策略一条条配。
- 多引擎共享:Spark、Trino、Ray、你的 Python 服务都要访问同一批表,需要一个统一的入口和一致的 schema 视图。
- 跨表原子操作:同时把 A、B 两张表切到新版本,或者整库回滚。文件名方案只能保证单表原子。
- 血缘、审计、生命周期管理这类治理需求。
- 表发现与命名:几百张表散在不同 bucket,需要按
2. MetaData Layer
刚才我们已经讨论了 version 控制层,通过 _versions/ 目录(倒序命名)+ latest_version_hint.json 实现,输出 (version, manifest 路径 path, manifest size) 三元组。这也被看成元数据的 L0 层。
2.1 L1:Manifest
2.1.1 File Footer
Lance 的 manifest、Data File 都是 footer 在末尾,内容在前,代价是读的时候得从后往前:先读 footer,才知道正文在哪。而"读 footer"意味着"读文件最后 N 个字节",这就必须先知道文件总长度。在对象存储上,标准流程是:
- HEAD 请求 → 拿到文件大小 size。
- GET range
[size-N, size)→ 读 footer,解析出manifest_pos。 - GET range
[manifest_pos, size)→ 读正文。
实际上,Lance 读版本时会先 LIST _versions/ 取第一条,而 LIST 返回的每个条目本来就自带 key、size、last-modified 等信息。既然大小已经到手,第 1 步的 HEAD 就可以直接跳过。之后 Lance 不是只读 footer 那几十个字节,而是直接读最后 64 KiB [size - 64KiB, size)。绝大多数表的 manifest 都不到 64 KiB,所以这一次 range 读就把 footer 和整个正文都拿到了,从而流程变成:
- LIST
_versions/取第一条。 - GET
[size - 64KiB, size)。 - 若还有剩余部分,切成若干块并发 GET range,总耗时 1 次往返。
具体来说,File Footer 结构基本如下,包含正文段的 offset、版本、Magic Code 3 个部分:
[正文若干段 ...]
[几个 "某某段从第几字节开始" 的偏移]
[u16 major | u16 minor]   ← 格式版本
["LANC"]                  ← 魔数,永远是文件最后 4 字节
2.1.2 Manifest Protobuf
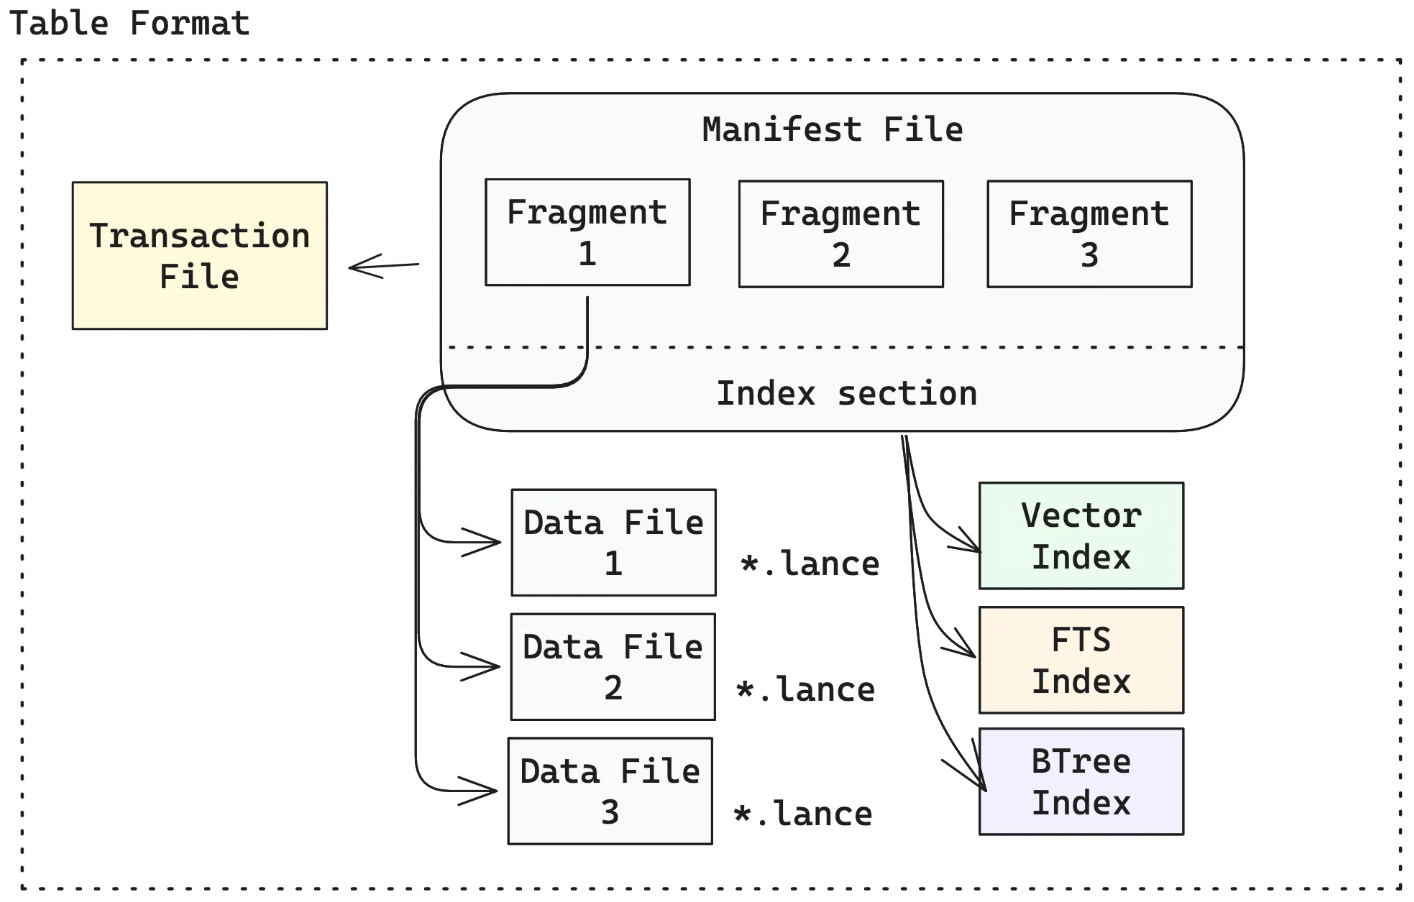
Manifest 文件包含以下部分:
- IndexSection(可选):这张表所有索引的元数据。写在最前面,Manifest 里用
index_section字段记它的 Offset。没有索引就整段不写。 - Transaction(可选):产生这个版本的那次事务的描述(做了什么操作、涉及哪些 fragment)。Manifest 用
transaction_section记它的 Offset。 - Manifest:主体,schema、fragment 列表、版本号等,是读表真正需要的东西。按"回答什么问题"归类:
- 身份:
version、timestamp、writer_version(哪个库的哪个版本写的,用来识别已知 bug)、data_format(数据文件是lance的哪个格式版本,一个版本内所有数据文件版本一致)、branch。 - schema:
fields[](扁平字段列表,见下文 Field ID)、schema_metadata。 - 数据:
fragments[]、max_fragment_id(下一个 fragment 从这里 +1,历史上用过的 id 不复用)、next_row_id(稳定行号计数器,未开启时为 0)。 - 兼容与配置:
reader_feature_flags/writer_feature_flags(位图,读/写者见到不认识的位必须拒绝)、config(lance.前缀保留给库)、table_metadata(用户自由键值)、base_paths[](多存储位置)。 index_section(可选):这张表所有索引的元数据,它从第几个字节开始。没有索引就整段不写。transaction_section(可选):产生这个版本的那次事务的描述(做了什么操作、涉及哪些 fragment)。本字段同样为它的 Offset。
- 身份:
例子如下,注意 manifest_pos = 783 指向的是 Manifest 段的长度前缀,不是 protobuf 本体。Manifest 内部的 transaction_section 字段会是 0,指向文件开头那个 Transaction 段;index_section 为空。
offset  size   content
0       4      u32 = 779                ← Transaction 段的长度
4       779    Transaction protobuf     ← 4 + 779 = 783
783     4      u32 = 833                ← Manifest 段的长度
787     833    Manifest protobuf        ← 787 + 833 = 1620
1620    8      i64 manifest_pos = 783   ← 指向 Manifest 段的长度前缀
1628    2      u16 major = 0
1630    2      u16 minor = 2
1632    4      "LANC"                   ← 1632 + 4 = 1636,文件结束
每个 manifest 都是自包含的:直接放着该版本的全部事实——schema、fragments[] 列表、版本号、时间戳,没有任何"参见上一版"的引用。_versions/ 里的任何一个文件单独拷出来,它描述的那一版表都能完整读出来。
代价是每次提交,哪怕只是 append 了一个新 fragment,也要把整个 fragments[] 列表连同旧的 fragment 一起重新写一遍,manifest 大小随 fragment 数线性增长。
Iceberg 的 Manifest file 是可以跨 snapshot 复用的。所以 Iceberg 每次提交的写入量和"这次改了多少"成正比,而不是和"表有多大"成正比;而 Lance 的 Manifest 每个版本完全重写。
Iceberg 是为 Hive 时代的数据湖设计的,Data File 小而多,一张大表有几十万到上百万个数据文件,那么如果 Manifest 每次重写,则每次重写几百 MB 元数据,因此它必须分层、必须复用没变的部分。
Lance 的变更单元是 fragment,fragment 设计偏大,数量少(这和它面向 ML/向量场景、经常整表扫描、需要 row id 稳定有关),一个 fragment 默认 100 万行,几十上百 MB,一张表通常几百到几万个 fragment。在这个量级下,全量重写 manifest 的代价是几 KB 到几 MB,付得起。这样的好处是读一个版本只需要一次文件读取,没有三层跳转;实现简单,没有跨版本引用要维护;删旧版本就是删文件。
Lance 的默认 fragment 是 100 万行,官方指南说几万个 fragment 是舒适区,并且要定期 compaction 合并小 fragment。
2.1.3 Field ID
fields[] 是扁平列表,嵌套关系靠 parent_id 表达(parent_id = -1 表示顶层字段)。
每个 Field 有:id、name、logical_type、nullable、metadata(三类:lance-encoding:* 编码配置、lance-schema:unenforced-primary-key 不强制主键、ARROW:extension:*)、以及主键/聚簇键位置。
field id 的规则和 Iceberg 完全一致:建表时按深度优先从 0 分配;之后新增字段拿下一个可用 id;一旦分配永不改变、永不复用。
2.2 L2:Fragment
Fragment 是按行切开,如每 100 万行(默认)切成一个 fragment;再在 fragment 内部竖着切,允许不同的列放在不同的文件里:
              field 0,1       field 2        field 5
fragment 0   [  file A  ]   [  file B  ]   [  file C  ]   ← 3 个文件,行数都是 1,000,000
fragment 1   [  file D  ]   [  file E  ]   [  file F  ]
fragment 2   [  file G  ]   [  file H  ]   [  file I  ]

field 0,1 是建表时写入的;field 2 是第一次 add_columns 产生的;field 5 是再加一次产生的
读取器读 fragment 0 的时候,把 A、B、C 三个文件按行偏移对齐拼起来:A 的第 k 行、B 的第 k 行、C 的第 k 行合成表的同一条记录,这要求同一个 fragment 的所有文件行数相等,都等于 physical_rows。这就是为什么加列不需要重写老文件——新列自己成一竖条,贴在旁边就行。
一个 DataFragment 条目回答"这一段行由什么拼成":
id:uint32,按max_fragment_id递增分配。files[]:一个或多个DataFile,每个只负责这段行的一部分列。DataFile有path(相对data/)、fields[](存了哪些 field id)、column_indices[](这些 field 分别是文件里第几个物理列)、file_major_version / file_minor_version(数据文件格式版本)、file_size_bytes(省一次 HEAD)、base_id(多存储位置时指向base_paths[]的哪一项,空表示相对数据集根)。deletion_file:可选,只是一个引用——file_type(ARROW_ARRAY / BITMAP)、read_version、id、num_deleted_rows——内容在_deletions/{fragment_id}-{read_version}-{id}.arrow|.bin。每个 fragment 在一个版本里最多一个删除文件,再删就写一个合并后的新文件替换引用。physical_rows:含已删行的总行数。逻辑行数 =physical_rows - deletion_file.num_deleted_rows。row_id_sequence、created_at_version_sequence、last_updated_at_version_sequence:开启稳定行号后才有,小于约 200 KB 内联为 bytes,否则写外部文件用ExternalFile{path, offset, size}引用。overlays[]:数据覆盖文件,实验特性,略。
删除文件时,每个 fragment 挂一个删除向量:一个记录"fragment 内第几行已删"的小文件,放在 _deletions/ 下。fragment 条目里的 deletion_file 只是一个引用,记文件类型、产生它的版本、一个 id、以及删了多少行。
Iceberg 的 DataFile 条目很多:分区值、每列的 min/max、null 数、值数、split offsets 等;而 Lance 的 fragment 条目只有路径、field id、行数,没有任何统计。min/max(zone map)、bloom filter、btree、bitmap 全部做成独立的标量索引放在 _indices/ 里,你要就建,不建就没有。
这样设计的原因是 Lance 的 manifest 是每次提交全量重写的。这类统计条目会占用大量空间,把统计移到索引里,manifest 保持瘦,统计成本只在需要的列上付。
2.3 IndexSection
-
索引段
注意
IndexMetadata[]里每一项描述的不是"一个索引",而是"一个索引段"。同一个name的多个段合起来才是一个索引。为什么要拆成段?因为 Lance 的数据文件不可变、fragment 只增不改,索引也顺着这个思路做成增量式的:第一次在 100 个 fragment 上建了向量索引,是一段;后来又 append 了 20 个 fragment,跑一次"优化索引",只对这 20 个新 fragment 建一小段,不重算前面 100 个。两段同名,都属于这个索引。查询时两段都查,结果合并。